


-
 자세히 보기
NVIDIA DGX Vera Rubin NVL72 GPU racks
액체 냉각 방식의 랙 규모 시스템으로, 에이전트형 AI 및 추론 모델의 학습 및 추론 속도를 높이는 동시에 토큰당 비용을 극대화합니다.
-
 자세히 보기
NVIDIA Vera CPU racks
대규모 생성 AI와 기타 트랜스포머 기반 워크로드의 훈련과 추론을 위한 NVIDIA Blackwell Ultra 기반 AI 시스템입니다.
-
 자세히 보기
NVIDIA Groq 3 LPX inference accelerator racks
NVIDIA Groq 3 LPX는 NVIDIA Vera Rubin을 위한 추론 가속기로, 에이전틱 시스템의 저지연 및 대규모 컨텍스트 요구 사항을 충족하도록 설계되었습니다.
-
 자세히 보기
NVIDIA BlueField-4 STX storage racks
액체 냉각 방식의 랙 규모 시스템으로, 에이전트형 AI 및 추론 모델의 학습 및 추론 속도를 높이는 동시에 토큰당 비용을 극대화합니다.
-
 자세히 보기
NVIDIA Spectrum-6 SPX Ethernet racks
대규모 생성 AI와 기타 트랜스포머 기반 워크로드의 훈련과 추론을 위한 NVIDIA Blackwell Ultra 기반 AI 시스템입니다.
-
 자세히 보기
NVIDIA CMX Context Memory Storage Platform
액체 냉각 방식의 랙 규모 시스템으로, 에이전트형 AI 및 추론 모델의 학습 및 추론 속도를 높이는 동시에 토큰당 비용을 극대화합니다.
NVIDIA Groq 3 LPX 엔비디아코리아 정품
- AI 추론 연산 315 PFLOPS
- 총 SRAM 용량 128 GB
- SRAM 대역폭 40 PB/s
- 스케일업 칩 수 256 Chips
- 스케일업 대역폭 640 TB/s

NVIDIA Vera Rubin을 위한 추론 가속기
지금까지의 AI 추론 아키텍처는 상호작용성과 처리량 사이에서 하나를 선택하면 다른 하나를 타협해야 하는 한계가 있었습니다. 지능을 포함한 이 세 가지 요소를 모두 양립하는 것은 불가능의 영역이었습니다. 그러나 진화한 에이전트 시스템은 그 이상의 혁신을 요구합니다. NVIDIA Groq 3 LPX는 에이전트 시스템의 핵심인 초저지연 성능과 방대한 컨텍스트 처리 요구를 완벽히 충족하는 NVIDIA Vera Rubin 전용 추론 가속기입니다. Vera Rubin과 LPX는 긴밀하게 공동 설계된 아키텍처를 통해 NVIDIA Rubin GPU와 LPU의 폭발적인 시너지를 구현합니다.
-
극저지연 시간과 대규모 처리량
HBM용 Rubin GPU와 SRAM용 LPU를 결합한 NVIDIA Vera Rubin with LPX는 수조 개의 매개변수를 가진 모델과 수백만 개의 토큰으로 구성된 컨텍스트에서 새로운 차원의 추론 성능을 제공합니다.
-
35배 더 높은 처리량
AI 팩토리는 방대한 토큰 처리량과 거대한 컨텍스트 윈도우를 저지연과 효율적인 비용 구조로 동시에 충족해야 합니다. LPX와 결합할 때 Vera Rubin은 1조 매개변수 모델에서 메가와트당 최대 35배 더 높은 처리량을 제공합니다.
-
새로운 추론 범주: 10배 수익 기회
추론 기반의 AI 에이전트가 가치를 만들어내려면 빠르고 방대한 맥락을 담은 ‘고가치 토큰’ 처리가 필수적입니다. LPX와 Vera Rubin 아키텍처를 결합하면 AI 데이터 센터에서 이 프리미엄 토큰을 대량 생산하여 전력당 수익성을 10배 높일 수 있습니다.
대규모 처리량을 갖춘 극히 낮은 지연 시간
고대역폭 메모리(HBM)를 위한 Rubin GPU와 정적 랜덤 액세스 메모리(SRAM)를 위한 LPU를 결합함으로써, LPX를 활용한 NVIDIA Vera Rubin은 1조 매개변수 모델 및 100만 토큰 컨텍스트를 위한 새로운 차원의 추론 성능을 제공합니다. Vera Rubin NVL72를 통해 배포된 Rubin GPU 및 LPU는 모든 출력 토큰에 대해 AI 모델의 모든 계층을 공동 계산하여 디코딩을 향상시킵니다.
새로운 차원의 AI 경험
Vera Rubin NVL 72는 Groq 3 LPX를 통해 높은 처리량과 낮은 지연 시간을 제공합니다.
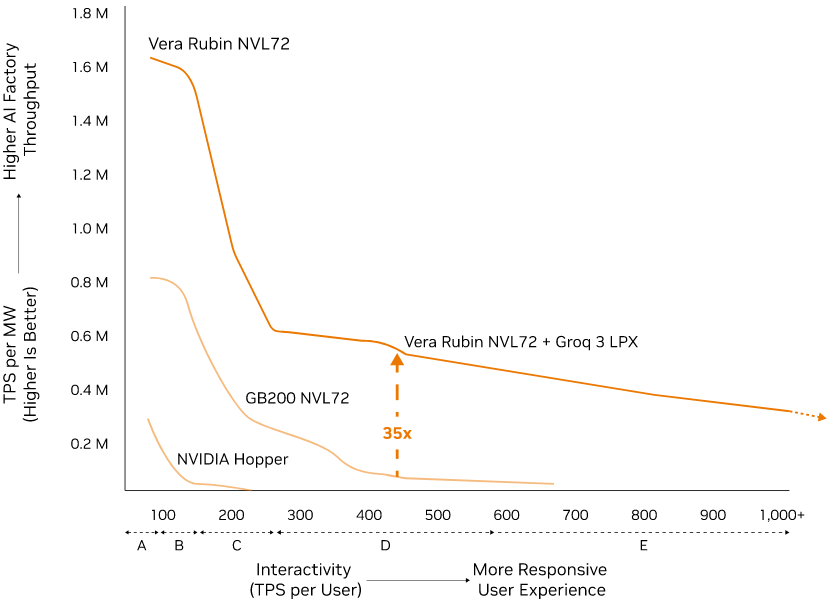
TPS: 초당 토큰. 예상 성능은 변경될 수 있습니다. 무료 티어(0달러): 32K KV-캐시 토큰을 갖춘 Qwen-3 2,350억 개의 매개변수 모델입니다. 중간 티어(3달러): 128K KV-캐시 토큰을 갖춘 Kimi K2.5 1조 매개변수 모델입니다. 상위 티어(6달러): GPT-MoE 128K KV 캐시 토큰을 탑재한 2조 파라미터 모델입니다. 프리미엄(45달러) 및 울트라(150달러) 티어: 400K KV-캐시 토큰을 갖춘 GPT-MoE 2조 매개변수 모델입니다.
3천억 달러 규모의 매출 기회를 여는 LPX
LPX가 Vera Rubin과 결합되면 AI 팩토리는 와트당 수익을 10배 더 높일 수 있습니다.

기가와트당 AI 팩토리 처리량 및 100만 토큰당 예상 비용 계층형 가격 모델을 기반으로 한 예상 수익입니다.
인터랙티브 추론(Interactive Inference)으로의 전환
AI 추론(AI Inference)을 위해 요구되는 성능의 스펙트럼이 매우 넓어지고 있습니다. 대규모 데이터 처리를 위한 고처리량(High-throughput) 백엔드를 안정적으로 운영하는 동시에, 사용자에게는 지연 없는 즉각적인 상호작용 경험을 제공해야 하기 때문입니다. 이처럼 서로 상반된 요구사항을 동시에 충족해야 하기에, 이기종(Heterogeneous) 추론 아키텍처의 중요성이 더욱 부각되고 있습니다.
처리량 최적화 (Throughput Optimized)
워크로드 목표
- GPU당 토큰 처리량 (Tokens per GPU)
- 전력당 토큰 처리량 (Tokens per Watt)
- 전체 비용 효율성 최대화 (overall cost efficiency)
대규모 공유 서비스 / 백그라운드 AI 기능 / 높은 자원 활용률이 중요
인터렉티브 AI 추론
Interactive AI Inference
다양한 스펙트럼을 갖고있으며
오늘날 많은 AI 플랫폼은 두가지 요구사항을 동시에 충족해야 합니다.
지연시간 최적화 (Latency Optimized)
중요 지표
- 첫 토큰 생성 시간(TTFT) 최소화
사용자당 초당 토큰 생성 속도 (Tokens per Second per User) 최대화
- 최약 구간 지연 시간(Tail Latency) 최소화
응답 지연 즉시 체감 -> 사용자 경험 결정

이기종(Heterogeneous) 추론 아키텍처의 중요성 확대
인터랙티브 추론이 더욱 어려워지는 이유
최근 AI 모델의 출력 길이와 컨텍스트가 증가하면서, 순차적으로 토큰을 생성하는 디코드 단계의 비중이 커지고 있습니다. 이로 인해 처리량보다 빠르고 일관된 응답성이 더욱 중요해졌으며, 특히 인터랙티브 AI 서비스에서는 저지연 성능이 핵심 경쟁력으로 부상하고 있습니다. 또한 긴 컨텍스트와 높은 동시 사용자 수는 메모리 대역폭 부담을 증가시키고 배치 처리 효율을 저하시켜, 처리량 중심 아키텍처만으로는 최적의 사용자 경험을 제공하기 어렵습니다. 이러한 문제는 추론과 도구 호출을 반복하는 에이전트형 AI에서 더욱 두드러지며, 안정적인 토큰 생성 속도와 우수한 테일 레이턴시 성능이 중요한 요소가 되고 있습니다.
-
저지연(Low-Latency)의
중요성 급부상인터랙티브 애플리케이션에서는 응답 속도가 단순한 인프라 성능 지표가 아니라, 사용자가 직접 체감하고 평가하는 제품 품질의 일부가 되었습니다.
-
더 길어진 추론 결과 (Longer Reasoning Outputs)
모델이 더 긴 답변과 다단계 추론 과정을 생성하면서, 전체 요청 처리 과정에서 순차적인 토큰 생성(Decode)이 차지하는 비중이 점점 커지고 있습니다.
-
프리픽스 캐싱
(Prefix Caching)공통 프롬프트 상태를 재사용하면 Prefill 비용은 줄어들지만, 상대적으로 Decode 작업의 비중이 커집니다. 따라서 남은 디코드 작업을 더 빠르게 처리하는 것이 핵심입니다.
-
확장되는 컨텍스트
(Longer Contexts)컨텍스트 길이가 증가할수록 Transformer의 Self-Attention 연산은 계산 성능보다 데이터 이동량과 메모리 대역폭의 제약을 더 크게 받게 됩니다.
NVIDIA Vera Rubin NVL72와 NVIDIA Groq 3 LPX의 결합을 통한
에이전트형 AI 시대를 위한 초저지연 추론 아키텍처
차세대 인터랙티브 AI 서비스는 방대한 컨텍스트 이해와 즉각적인 응답성을 동시에 요구하지만, 두 작업은 컴퓨팅 특성이 달라 단일 하드웨어로 해결하기 어렵습니다. 이에 따라 긴 컨텍스트 처리와 대규모 KV 캐시 구축은 높은 병렬성과 대용량 메모리를 갖춘 NVIDIA Vera Rubin NVL72가 담당하고, 사용자가 체감하는 디코드 단계의 초저지연 토큰 생성은 Groq 3 LPX가 전담하도록 역할을 분리합니다. 이러한 최적화된 협업 구조를 통해 기업은 처리량과 응답성 사이에서 타협할 필요 없이 두 가지 가치를 동시에 확보하고 사용자 경험을 획기적으로 향상시킬 수 있습니다.

-
NVIDIA Rubin GPU
- 288 GB HBM4
- 22 TB/s
- 50 PFLOPs (NVFP4)
-
NVIDIA Groq3 LPU
- 500 MB SRAM
- 150 TB/s SRAM Bandwidth
- 1.2 PFLOPs (FP8)
Vera Rubin in Full Production

NVIDIA Groq 3 LPX 컴퓨팅 트레이 사양
랙 장착형, 액체 냉각 방식의 1U 컴퓨팅 엔진으로 저지연 추론을 지원합니다.

| Resource | Per LPX Tray | Resource | Per LPX Tray |
|---|---|---|---|
| LP30 chips | 8 | DRAM via host CPU | Up to 128 GB |
| On-chip SRAM | 4 GB | AI inference compute (FP8) | 9.6 PFLOPS |
| SRAM bandwidth | 1.2 PB/s | Scale-up bandwidth | 20 TB/s |
| DRAM via fabric expansion logic | Up to 256 GB |
NVIDIA Elite Partner 리더스시스템즈는 AI 데이터센터, 스마트 팩토리 및
물류 자동화 구축을 위한 AI Full-Stack 통합 솔루션을 제공합니다.
회사소개 바로가기
-

NVIDIA Partner Network 인증 파트너
리더스시스템즈는 NVIDIA Elite Partner로서 Blackwell 기반 DGX 도입 경험을 바탕으로 소프트웨어 스택(NVIDIA AI Enterprise) + 시스템 튜닝을 고객의 워크로드에 맞춰 최적화 하여, AI 활용 효율성과 투자 대비 성과(ROI)를 동시에 확보합니다.
-
AI 인프라 구축·운영 토탈 서비스
리더스시스템즈는 AI 인프라 설계 > 구축 > 운영 > 최적화까지 모든 단계를 직접 지원합니다. 고객의 비즈니스 확장 속도에 맞춘 모듈형 확장, 미션 크리티컬 데이터센터 요구 조건을 충족하는 고가용성 & 보안 설계로 장기 운영 신뢰성을 보장합니다.
-

운영 효율을 높이는 전문 기술 지원
리더스시스템즈의 AI 전문가가 구축 이후에도 모니터링, 정기 점검, 운영 교육을 지속적으로 지원하며, 이슈 발생 시 신속한 대응으로 다운타임을 최소화합니다. 또한 자원 활용 효율을 높여 전력 및 유지 비용 절 감과 데이터센터 TCO 최적화를 실현합니다.
-

글로벌 파트너십 기반 Full-Stack 공급
DGX System 도입에 필요한 보안 솔루션, 안정적인 전력 공급을 위한 UPS, 냉각 시스템, 네트워크 및 스토리지까지 각 분야에 맞는 검증된 글로벌 기업들과의 기술 협력을 통해 데이터센터 구축을 위한 통합 솔루션을 제공합니다.
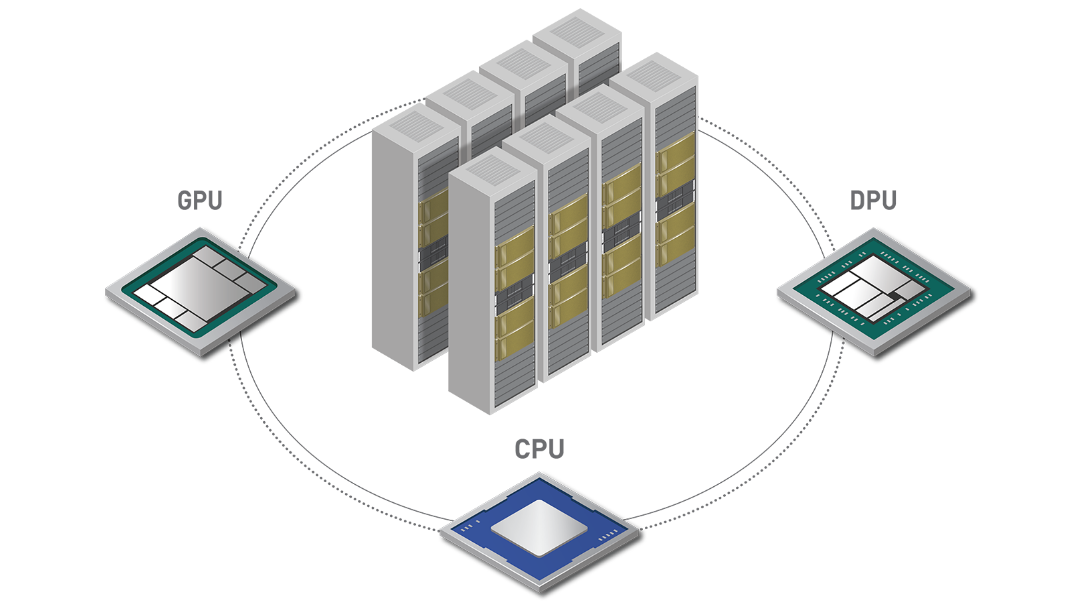
AI와 데이터 분석에서 고성능 컴퓨팅(HPC)과 렌더링까지, NVIDIA 통합 플랫폼
GPU, DPU 및 CPU용 3개의 차세대 아키텍처를 기반으로 구축된 NVIDIA 가속 컴퓨팅 플랫폼으로 AI 시대의 데이터센터를 재구성하세요.
이러한 아키텍처는 성능, 보안, 네트워킹 등을 포괄하는 최첨단 기술을 통해 최신 데이터센터의 모든 문제를 처리할 준비가 되어 있습니다.

AI 인프라의 확장성을 위한 NVIDIA BlueField-4 DPU
NVIDIA BlueField-4는 기가스케일 AI 팩토리를 위한 800Gb/s 인프라 플랫폼입니다. 이전 모델보다 6배 향상된 컴퓨팅 성능을 제공하며, 네트워킹, 데이터 스토리지, 사이버 보안 가속 기능을 탑재하여 새로운 차원의 성능을 구현, 데이터 이동 병목 현상을 최소화하며, 전력 효율성을 개선하고 AI 인프라의 확장성을 극대화합니다.
자세히 보기
AI 및 클라우드를 위한 가속 Ethernet Switch | NVIDIA Spectrum SN6000 Series
NVIDIA Spectrum™ Ethernet Switch는 소프트웨어 및 하드웨어의 모든 계층에서 네트워킹 속도를 향상시켜 줍니다. SN6000 제품군 Ethernet Switch는 코패키징된 광학 모듈을 통해 AI 팩토리에 전례 없는 네트워크 확장성을 제공하며, 이전 세대 대비 레인당 대역폭을 두 배로 늘리고 네트워크 복원력을 크게 향상시킵니다.
자세히 보기System Specifications (Rack-Scale)
| Platform Integration | NVIDIA Vera Rubin Platform (Heterogeneous Inference Architecture) |
|---|---|
| AI Inference Compute (FP8) | 315 PFLOPS |
| Total SRAM Capacity | 128 GB |
| On-Chip SRAM Bandwidth | 40 PB/s |
| Scale-Up Density | 256 Groq 3 LPU Accelerators (32 Trays) |
| Scale-Up Bandwidth | 640 TB/s |
- * 사양은 변경될 수 있습니다.
Compute Tray Specifications
| LP30 chips | 8 Chips (Groq 3 LPU / LP30) |
|---|---|
| On-chip SRAM | 4 GB |
| SRAM bandwidth | 1.2 PB/s |
| DRAM via fabric expansion logic | Up to 256 GB |
| Scale-Up Density | Up to 128 GB |
| AI inference compute (FP8) | 9.6 PFLOPS |
| Scale-up bandwidth | 20 TB/s |
- * 사양은 변경될 수 있습니다.
모든 AI 엔터프라이즈를 위한 슈퍼컴퓨팅 솔루션
-
 자세히 보기
NVIDIA DGX SuperPOD
액체 냉각 방식의 랙 규모 시스템으로, 에이전트형 AI 및 추론 모델의 학습 및 추론 속도를 높이는 동시에 토큰당 비용을 극대화합니다.
-
 자세히 보기
Enterprise AI 데이터 센터를 위한
NVIDIA AI Enterprise는 신뢰할 수 있고 안전하며 확장 가능한 AI 운영을 보장하는 동시에 출시 시간을 가속화하고 인프라 비용을 절감할 수 있습니다.
-
 자세히 보기
NVIDIA DGX 고객을 위한 DLI
NVIDIA Deep Learning Institute (DLI)의 AI 전문가가 제공하는 전용 기술 교육을 통해, 최첨단 AI 혁신을 더 빠르게 달성하는 방법을 배울 수 있습니다.